
Stable Diffusion 是一款免費開源的 AI 圖像生成模型,任何人都能透過文字描述(Prompt)產出高品質圖片。截至 2026 年,Stable Diffusion 已從最初的 v1.5 演進到 SDXL、SD3 及 Stability AI 最新的模型架構,功能與畫質都大幅提升。本篇教學將從零開始,帶你了解 Stable Diffusion 的核心概念、4 種主流安裝方式、WebUI 操作介面,以及咒語(Prompt)撰寫技巧,讓你快速上手 AI 繪圖。
看完本篇可以學到:
Stable Diffusion 是什麼?完整介紹
Stable Diffusion(穩定擴散模型)是由 Stability AI 開發的開源文字轉圖像(Text-to-Image)AI 模型,任何人都能免費下載、修改與商業使用。它與 Midjourney、DALL-E 3 並列為 2026 年三大主流 AI 繪圖工具,但最大的差異在於 Stable Diffusion 完全開源,使用者可以在自己的電腦上運行,不需要付月費。
Stable Diffusion 的運作原理是「擴散模型」(Diffusion Model):先將圖片加入隨機雜訊直到變成純噪點,再訓練神經網路學會「逆向去噪」的過程。當你輸入一段文字描述,模型會從隨機噪點開始,一步步去噪還原出符合描述的圖像。
關於 AI 繪圖的更多工具比較,可參考AI 繪圖完整指南。
Stable Diffusion 主要版本差異比較
截至 2026 年 3 月,Stable Diffusion 已推出多個重要版本,各版本在畫質、速度與功能上有顯著差異。以下是主要版本的比較:
| 版本 | 發布時間 | 預設解析度 | 主要特色 | 適合對象 |
|---|---|---|---|---|
| SD 1.5 | 2022 年 10 月 | 512×512 | 模型生態最豐富、LoRA / ControlNet 資源最多 | 入門練習、需要大量社群模型的使用者 |
| SDXL 1.0 | 2023 年 7 月 | 1024×1024 | 畫質大幅提升、支援雙 CLIP 編碼器 | 追求高畫質的進階使用者 |
| SD3 Medium | 2024 年 6 月 | 1024×1024 | MMDiT 架構、文字渲染能力改善 | 需要圖片內嵌文字的創作者 |
| SDXL Turbo / Lightning | 2024 年 | 512×512~1024×1024 | 1-4 步即可出圖、近乎即時生成 | 需要快速迭代的工作流程 |
對初學者而言,建議從 SDXL 1.0 開始學習,因為它的畫質與社群資源取得了最佳平衡。SD 1.5 雖然較舊,但擁有最龐大的自訂模型(Checkpoint)與 LoRA 生態系,仍被大量使用者採用。
4 種 Stable Diffusion 安裝方式完整教學
安裝 Stable Diffusion 主要有 4 種方式:本機安裝、Google Colab 雲端、ComfyUI 節點式介面,以及免安裝線上工具。每種方式各有優缺點,以下逐一說明。
方法 1:本機安裝(Automatic1111 WebUI)
本機安裝是最多人使用的方式,優點是完全免費、不限使用時間,缺點是需要一張至少 6GB VRAM 的 NVIDIA 顯示卡(如 RTX 3060 以上)。
系統需求:
- 作業系統:Windows 10/11 或 Linux(macOS 可用但效能較差)
- 顯示卡:NVIDIA GPU,建議 8GB VRAM 以上(RTX 3060 12GB 為高 CP 值選擇)
- 記憶體:16GB RAM 以上
- 硬碟空間:至少預留 30GB(模型檔案較大)
- 前置軟體:Python 3.10、Git
安裝步驟:
- 安裝 Python 3.10(安裝時勾選「Add to PATH」)
- 安裝 Git
- 開啟終端機,輸入
git clone https://github.com/AUTOMATIC1111/stable-diffusion-webui.git - 進入資料夾,執行
webui-user.bat(Windows)或./webui.sh(Linux/Mac) - 首次啟動會自動下載相依套件,約需 10-20 分鐘
- 瀏覽器開啟
http://127.0.0.1:7860即可使用
方法 2:Google Colab 雲端運行
Google Colab 讓你免費借用 Google 的 GPU 來跑 Stable Diffusion,不需要高階顯卡。不過要注意:自 2023 年起 Google 已限制免費版 Colab 執行 SD WebUI,目前建議使用 Colab Pro(每月約 US$10)才能穩定運行。
- 優點:不需要高階電腦、隨開隨用
- 缺點:免費版受限制、有使用時數上限、每次重新啟動需重新載入模型
- 推薦 Notebook:搜尋「stable-diffusion-webui colab」可找到社群維護的 Colab 筆記本
方法 3:ComfyUI 節點式介面(進階推薦)
ComfyUI 是 2024-2026 年快速崛起的 Stable Diffusion 前端介面,採用節點式(Node-based)工作流程,類似 Blender 的節點編輯器。它的優點是記憶體使用效率更高、支援更複雜的工作流程,且對 SDXL 和 SD3 的支援比 A1111 更即時。
- 適合對象:想要精細控制生圖流程的進階使用者
- 安裝方式:從 GitHub 下載,解壓後執行即可
- 學習曲線:比 A1111 WebUI 陡峭,但彈性更大
方法 4:免安裝線上工具
如果你只想快速體驗 AI 繪圖、不想安裝任何軟體,以下線上平台可以直接使用:
| 平台 | 費用 | 特色 | 限制 |
|---|---|---|---|
| Stable Diffusion Online | 免費 | 零門檻、即開即用 | 畫質較低、排隊等候時間長 |
| Clipdrop by Stability AI | 免費 / 付費 | 官方出品、支援 SDXL | 免費版有每日生成上限 |
| CivitAI Generate | 免費 / 付費 | 可直接套用社群模型 | 免費額度有限 |
| Tensor.Art | 免費 / 付費 | 支援多種模型、介面友善 | 每日免費額度約 100 張 |
實戰經驗:我自己最常用的組合是「本機 ComfyUI + SDXL」處理正式專案,用「CivitAI Generate」快速測試不同模型的風格效果。如果你的電腦沒有獨立顯卡,Tensor.Art 的免費額度對初學者來說已經非常夠用,不需要急著花錢升級硬體。
Stable Diffusion WebUI 介面完整教學
Automatic1111 WebUI 是目前最多人使用的 Stable Diffusion 圖形介面,所有操作都在瀏覽器中完成。以下是主要功能區塊的說明:
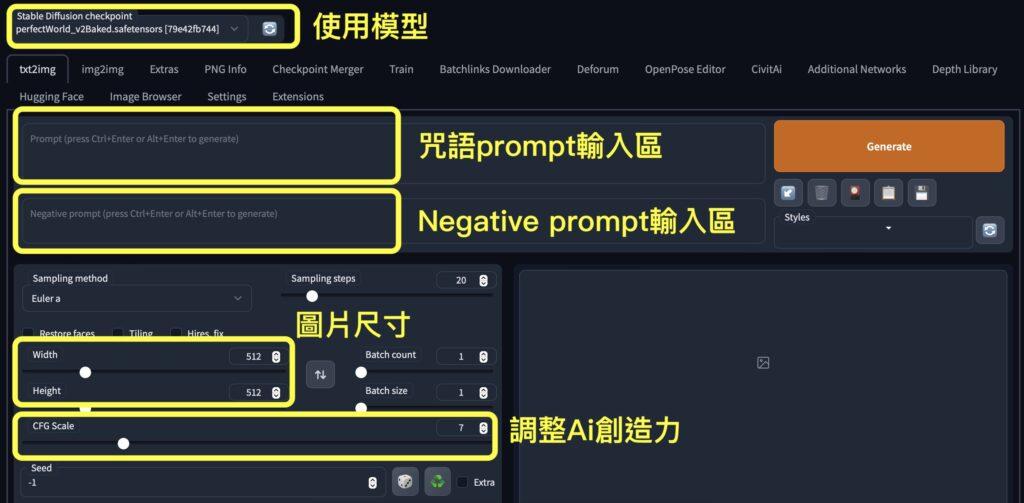
- Prompt(正向提示詞):描述你想要的圖片內容,例如「a girl with red hair, sunset, oil painting style」
- Negative Prompt(反向提示詞):排除不想要的元素,例如「blurry, low quality, deformed hands」
- Sampling Method(取樣方法):推薦 DPM++ 2M Karras 或 Euler a,前者品質穩定,後者變化性大
- Sampling Steps(取樣步數):一般設 20-30 步,步數越高品質越好但速度越慢
- CFG Scale(提示詞引導強度):建議 7-12,數值越高越嚴格遵循提示詞
- Seed(種子碼):固定種子碼可重現同一張圖,設為 -1 則每次隨機
- Batch Size / Count:一次生成的圖片數量
Stable Diffusion 咒語(Prompt)撰寫教學
Prompt(提示詞,又稱「咒語」)是決定 AI 繪圖成敗的關鍵,好的 Prompt 能讓出圖品質提升 80% 以上。以下是撰寫高品質 Prompt 的系統化方法:
Prompt 基本結構
一個完整的 Prompt 通常包含以下要素,依重要性排序:
- 主體描述:1girl, solo, standing(角色、數量、姿勢)
- 外觀細節:red hair, blue eyes, white dress(髮色、眼色、服裝)
- 場景環境:in a garden, cherry blossom, sunset(地點、物件、光線)
- 風格與品質:masterpiece, best quality, realistic, 8k(畫風、解析度)
- 鏡頭語言:close-up, wide shot, from above(拍攝角度)
Negative Prompt 常用範本
Negative Prompt 用來排除常見的 AI 繪圖瑕疵:
lowres, bad anatomy, bad hands, text, error, missing fingers, extra digit, fewer digits, cropped, worst quality, low quality, normal quality, jpeg artifacts, signature, watermark, username, blurry, deformed
進階技巧:權重調整與分步提示
- 加權:用括號提高權重,如
(red hair:1.3)表示紅髮的影響力提高 1.3 倍 - 降權:用方括號降低權重,如
[glasses]或(glasses:0.5) - 分步提示:用
[from:to:step]在不同步數切換提示詞,創造漸變效果
更多關於 AI 繪圖 Prompt 的進階技巧,可參考 AI 繪圖咒語 Prompt 生成器教學。
img2img 圖生圖功能教學
img2img(Image-to-Image)是 Stable Diffusion 的核心功能之一,讓你以現有圖片為基礎,透過 AI 重新繪製或風格轉換。這個功能特別適合:
- 將草稿或線稿轉換為完整插畫
- 改變照片的藝術風格(如照片轉動漫)
- 局部修改圖片中的特定區域(搭配 Inpaint 功能)
操作步驟:
- 在 WebUI 切換到「img2img」分頁
- 上傳一張參考圖片
- 在 Prompt 輸入你想要的風格描述
- 調整「Denoising Strength」(去噪強度):0.3-0.5 保留較多原圖,0.7-0.9 變化較大
- 按下 Generate 生成
ControlNet 與 LoRA:進階擴充功能
ControlNet 和 LoRA 是讓 Stable Diffusion 從「堪用」躍升到「專業級」的兩大關鍵擴充。
ControlNet:精準控制構圖
ControlNet 能讓你透過骨架圖、邊緣偵測、深度圖等方式精準控制 AI 生成的構圖。例如上傳一張人物骨架姿勢圖,AI 就會按照該姿勢生成角色。
- Openpose:偵測人體骨架,控制角色姿勢
- Canny:邊緣偵測,保留輪廓線條
- Depth:深度圖,控制前後景距離
- Tile:高解析度重繪,提升細節品質
LoRA:輕量化風格微調模型
LoRA(Low-Rank Adaptation)是一種輕量化的模型微調技術,檔案通常只有 10-200MB(相比完整模型的 2-7GB)。你可以在 CivitAI 下載數千種社群製作的 LoRA,涵蓋特定角色、畫風、服裝等風格。
使用方式:將 LoRA 檔案放入 models/Lora 資料夾,在 Prompt 中加入 <lora:模型名稱:權重>,例如 <lora:anime_style:0.8>。
Stable Diffusion 模型下載與推薦資源
模型(Checkpoint)是 Stable Diffusion 的核心,不同模型會產生截然不同的畫風與品質。以下是 2026 年最受歡迎的模型資源平台與推薦模型:
模型下載平台
| 平台 | 特色 | 網址 |
|---|---|---|
| CivitAI | 最大的 SD 模型社群、含預覽圖與評分 | civitai.com |
| Hugging Face | 官方模型發布平台、技術文件完整 | huggingface.co |
| MajinAI | AI 繪圖作品分享社群、可查看他人使用的模型與參數 | majinai.art |
| PixAI.Art | 線上看圖 + 算圖,適合找靈感 | pixai.art |
2026 年熱門模型推薦
- 寫實風格:Realistic Vision(SD1.5)、RealVisXL(SDXL)
- 動漫風格:Anything V5(SD1.5)、Animagine XL(SDXL)
- 通用高品質:DreamShaper(SD1.5/SDXL 都有)、Juggernaut XL(SDXL)
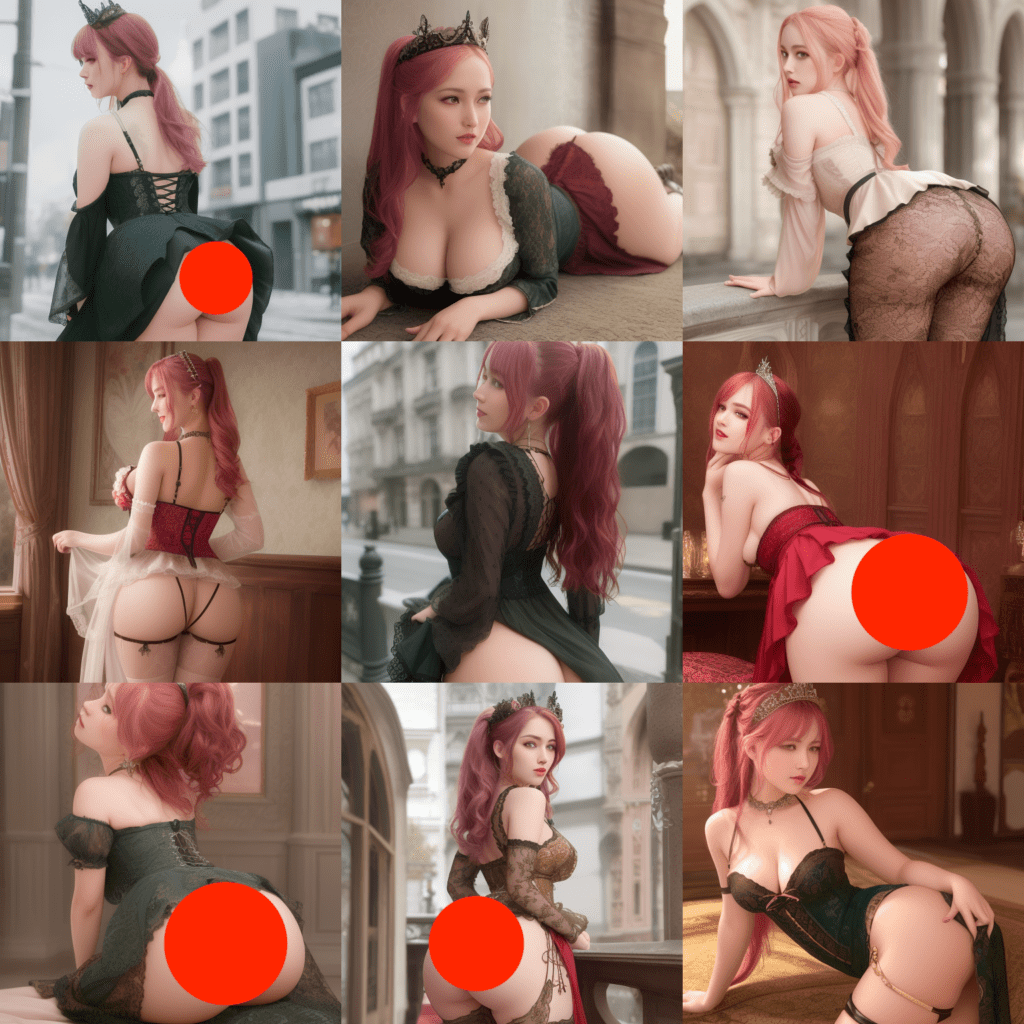
Stable Diffusion vs Midjourney vs DALL-E 3 比較
三大 AI 繪圖工具各有優缺點,選擇取決於你的需求、預算與技術能力。
| 比較項目 | Stable Diffusion | Midjourney | DALL-E 3 |
|---|---|---|---|
| 費用 | 免費開源 | US$10-60/月 | 含於 ChatGPT Plus(US$20/月) |
| 運行方式 | 本機 / 雲端 | Discord / 官網 | ChatGPT / API |
| 客製化程度 | 極高(可換模型、加 LoRA、ControlNet) | 低(只能調參數) | 低 |
| 上手難度 | 中高(需安裝與學習) | 低(打字即可) | 最低(自然語言描述) |
| 畫質(預設) | 依模型而定 | 高(v6 版尤佳) | 中高 |
| 中文支援 | 需英文 Prompt | 支援中文(v6+) | 支援中文 |
| 商業授權 | 開源免費 | 付費方案可商用 | 可商用(依 OpenAI 條款) |
實戰建議:如果你是設計師或需要大量客製化出圖,Stable Diffusion 的長期成本最低且彈性最高。如果你只是偶爾需要生成圖片、不想學技術,Midjourney 或 DALL-E 3 的門檻更低。我個人的工作流程是:用 DALL-E 3 快速驗證概念構圖,再用 Stable Diffusion + ControlNet 精修最終成品。
Stable Diffusion 常見問題與疑難排解
初學者在安裝與使用 Stable Diffusion 時最常遇到 VRAM 不足、出圖品質差、安裝失敗三大問題。以下逐一說明解決方案:
VRAM 不足怎麼辦?
- 在啟動參數加入
--medvram或--lowvram降低顯存使用量 - 將解析度降至 512×512(SD1.5)或 768×768(SDXL)
- 使用 ComfyUI 替代 A1111,記憶體管理更有效率
- 若顯卡 VRAM 低於 4GB,建議改用雲端方案
生成的圖片品質很差?
- 檢查是否有加入品質相關 Prompt:masterpiece, best quality, highly detailed
- 確認 Negative Prompt 已排除常見瑕疵
- Sampling Steps 至少設 20 步以上
- 嘗試更換模型,不同模型的基礎品質差異很大
安裝時報錯怎麼辦?
- 確認 Python 版本為 3.10.x(非 3.11 或 3.12,相容性較差)
- 確認 NVIDIA 驅動程式已更新至最新版
- Windows 使用者確認路徑中沒有中文字元
- 若遇到 torch 安裝失敗,嘗試手動安裝對應 CUDA 版本的 PyTorch
Stable Diffusion AI 繪圖實戰操作指引
以下是從零開始到產出第一張高品質 AI 圖片的完整步驟,適合完全沒有經驗的初學者跟著做。
- 選擇安裝方式:有 NVIDIA 顯卡(6GB+ VRAM)選本機安裝 A1111 或 ComfyUI;沒有獨顯選 Tensor.Art 或 CivitAI Generate 線上平台
- 下載模型:到 CivitAI 挑一個評分高的 Checkpoint(推薦 DreamShaper 或 Realistic Vision),放入
models/Stable-diffusion資料夾 - 撰寫第一組 Prompt:參考本文的 Prompt 結構公式,從「主體 + 外觀 + 場景 + 品質」四要素開始,同時填入 Negative Prompt 範本排除瑕疵
- 調整參數並生成:Sampling Method 選 DPM++ 2M Karras、Steps 設 25、CFG Scale 設 7、解析度 512×768,按下 Generate
- 迭代優化:觀察生成結果,微調 Prompt 用詞、增減權重括號,找到滿意的種子碼(Seed)後固定它
- 進階擴充:安裝 ControlNet 控制姿勢構圖、下載 LoRA 增加特定風格、使用 img2img 從現有圖片重繪
關於 AI 詠唱師這個新興職業與 Prompt 工程的深入探討,可參考我們的專題文章。
Stable Diffusion 是什麼?
Stable Diffusion 是由 Stability AI 開發的免費開源 AI 圖像生成模型。使用者只需輸入文字描述(Prompt),AI 就會自動生成對應的圖片。它是目前唯一完全開源、可在個人電腦上運行的主流 AI 繪圖工具。
Stable Diffusion 需要什麼電腦配備?
建議至少要有 NVIDIA RTX 3060(12GB VRAM)以上的顯示卡、16GB RAM 和 30GB 硬碟空間。若沒有獨立顯卡,可改用 Google Colab 雲端方案或 Tensor.Art 等免安裝線上工具。
Stable Diffusion 可以免費使用嗎?
可以。Stable Diffusion 本身是免費開源軟體,本機安裝完全不用付費。線上版如 Stable Diffusion Online、Clipdrop、CivitAI Generate 和 Tensor.Art 也都提供免費額度。
Stable Diffusion 和 Midjourney 哪個比較好?
各有優勢。Stable Diffusion 免費開源、客製化程度極高,適合需要大量出圖或特定風格的使用者。Midjourney 上手容易、預設畫質高,適合不想學技術的使用者。以長期成本而言,Stable Diffusion 更划算。
Stable Diffusion 咒語(Prompt)怎麼寫?
Prompt 建議按「主體描述 > 外觀細節 > 場景環境 > 風格品質 > 鏡頭語言」的順序撰寫,用英文逗號分隔。同時搭配 Negative Prompt 排除常見瑕疵如 bad anatomy、low quality 等。可用括號加權重,如 (red hair:1.3) 強調特定元素。
Stable Diffusion 生成的圖片可以商業使用嗎?
Stable Diffusion 模型本身採用開源授權,生成的圖片可以商業使用。但若使用第三方 LoRA 或特定 Checkpoint 模型,需注意該模型的授權條款。建議使用 CivitAI 下載模型時確認其授權類型。
2026 年 Stable Diffusion 最推薦用哪個版本?
截至 2026 年 3 月,建議初學者從 SDXL 1.0 開始,因為畫質與社群資源取得最佳平衡。需要大量社群模型(LoRA、Checkpoint)的使用者仍可選 SD 1.5。追求最新技術的進階使用者可嘗試 SD3 或 Stability AI 的最新模型。