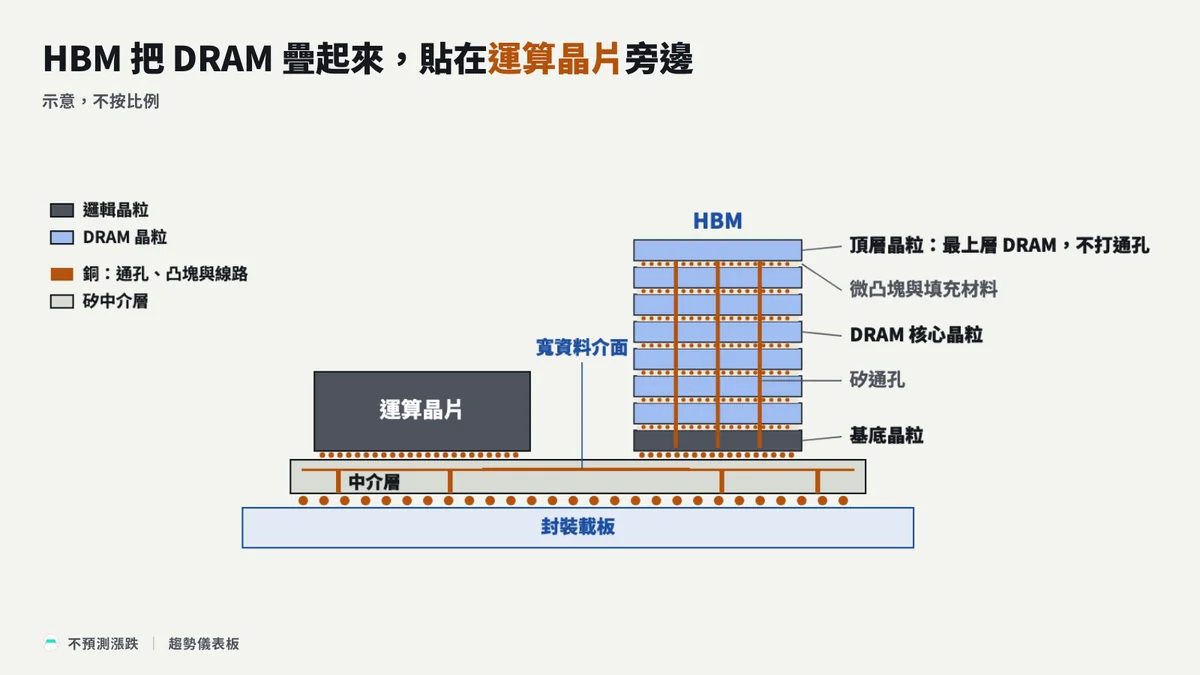
HBM 是高頻寬記憶體 High Bandwidth Memory 的縮寫,做法是把多層 DRAM 晶粒垂直疊起來,用貫穿晶粒的矽通孔上下連接,再以一條很寬的資料介面接到旁邊的運算晶片12。用途是替 AI 加速器與高效能運算晶片快速供應大量資料1。DRAM 是用電容存資料、需要定期刷新的記憶體,HBM 的資料就存在這些 DRAM 晶粒裡,和一般 DRAM 產品的差別在疊法、介面寬度與擺放位置。新聞常見的 HBM3E、HBM4 是世代名稱,E 代表同一代的強化版。
一組 HBM 長怎樣
由下往上拆一組 HBM,每一層都是一顆晶粒,也就是從晶圓切下、還沒封裝的晶片。最下面是基底晶粒,負責控制與連接,把記憶體訊號整理好、送到加速器3。上面是一層層磨薄的 DRAM 核心晶粒4。依美光的 HBM4 產品說明,最上面那層 DRAM 核心晶粒不打通孔,又稱頂層晶粒5。
矽通孔又稱矽穿孔,英文縮寫 TSV,做法是在晶粒上打穿垂直小孔、灌進銅,訊號沿著銅柱一路往下到基底晶粒26。每層要拉出好幾千條線,從側邊拉線放不下,才改從晶粒中間往下穿6。層與層之間靠微凸塊接合,堆疊時加熱加壓讓錫熔化焊在一起,再用填充材料把縫隙填滿固定6。
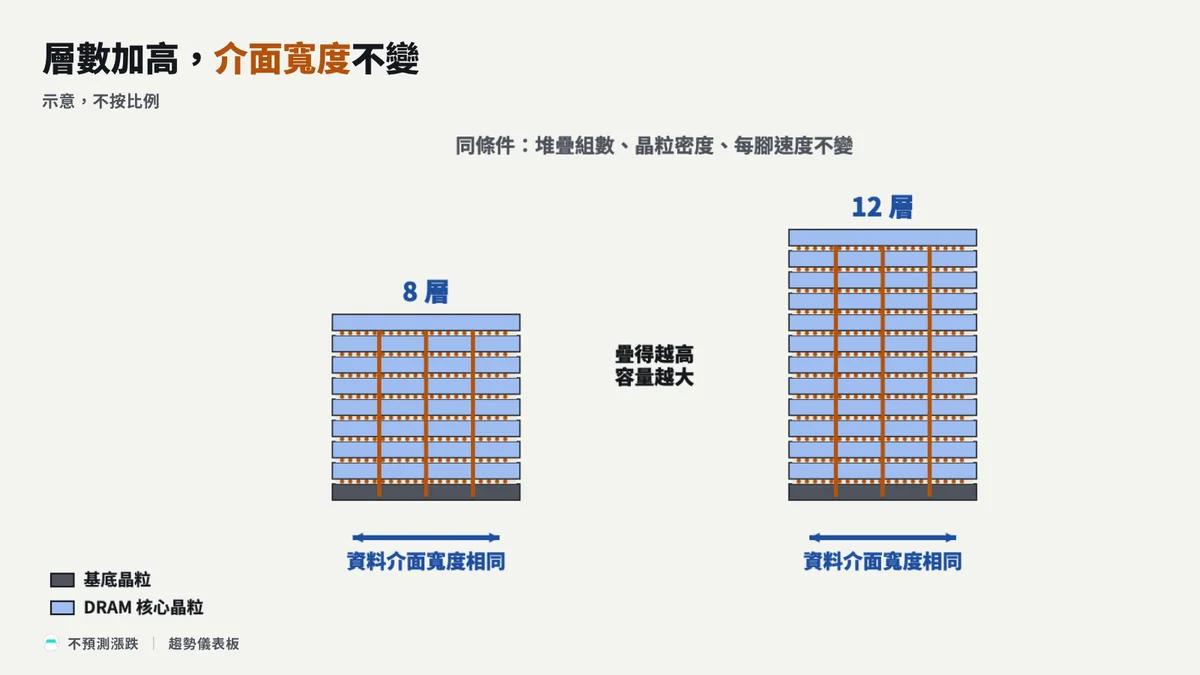
新聞說的 8 層、12 層,是一組 HBM 裡疊了幾層 DRAM4。以美光量產的 HBM4 為例,一組疊 12 層、容量 36GB7。
頻寬從哪裡來:介面做寬、距離拉近
頻寬是每秒能搬多少資料,等於傳輸頻率乘上位元寬度,位元寬度就是同時傳資料的線路條數6。頻率拉得太高,訊號來不及穩定,相鄰導線的干擾也會惡化,HBM 因此選擇把位元寬度做寬。依站內研報,家用顯示卡上的 GDDR 單顆約 32 位元,HBM3E 單顆是 1024 位元6。
這麼寬的介面要同時跑上千條平行線路,線越長,訊號越難對齊、耗電也越高,HBM 只好貼在運算晶片旁邊,目前的 AI 加速器多半把兩者並排放在同一片中介層上,靠中介層裡的細密線路相連24。
容量和頻寬是兩件事
規格表上的記憶體容量與頻寬是兩個獨立的數字。站內 GPU 研報把頻寬比作走廊多寬,容量比作倉庫多大8。回到實物,頻寬是每秒能從 HBM 搬多少資料進運算晶片,靠記憶體介面往上加;容量是 HBM 總共裝得下多少資料,靠每張卡掛多少記憶體往上加8。
輝達 H200 是現成的例子:它沿用 H100 同一顆運算晶粒,算力沒有增加,記憶體容量從 80GB 加到 141GB,頻寬從每秒 3.35 TB 加到 4.8 TB8。
疊更多層,加的主要是容量。依站內記憶體研報的同條件推算,堆疊組數、晶粒密度與每腳速度都不變時,12 層改成 8 層,容量變成三分之二,總頻寬不變7。層數多,不等於整台機器跑得快。
為什麼現在大家在談 HBM
語言模型生成文字時一次輸出一個字,這裡的字指輸出單位 token;每輸出一個,都要把用到的權重從 HBM 讀過一次,每個權重只做一次乘法和一次加法8。以 700 億參數、16 位元精度、每個字都用到全部權重的模型為例,權重共 140GB,平均每讀 1 位元組只做 1 次運算8。依輝達規格重算,H100 要每讀 1 位元組做到約 295 次運算,運算單元才會忙滿;單一請求生成時差了約三百倍,運算單元多半在等資料8。
換成速度,H100 每秒讀 3.35 TB,讀完 140GB 約 41.8 毫秒,單一請求每秒的理論上限約 23.9 個字8。要變快,只能讓每個字少讀一些資料,或把資料送得更快,後者靠的是更寬、更快的 HBM8。
容量是另一道牆。140GB 的模型裝不進 80GB 的 H100,得拆到兩張以上、壓低權重精度,或換記憶體更大的機台8。晶片廠的對策是每張卡掛更多 HBM8:依輝達規格,H100 搭 80GB 的 HBM3,B300 搭 288GB 的 HBM3E,下一代 Rubin 同樣 288GB,換成 HBM44。依 TrendForce 的預估,HBM 占 DRAM 晶圓投片的比重到 2027 年還會繼續升高8。
另一個變化在基底晶粒。標準 HBM 依記憶體標準組織 JEDEC 的規範,基底晶粒與加速器之間的介面固定,任何記憶體廠的 HBM 都接得上相容的加速器3。客製 HBM 不動上面的 DRAM,改用先進邏輯製程做基底晶粒,把 HBM 控制器等原本放在加速器上的介面邏輯搬進去3;輝達公布的 NVHBM,就是把自研記憶體控制器做進基底晶粒9。
HBM 和 GDDR、桌機記憶體條差在哪
三者用的都是 DRAM,差在放哪裡、怎麼接。家用顯示卡的 GPU 周圍排著一圈獨立的 GDDR 顆粒;AI 加速器把 HBM 疊成一小疊,直接封進 GPU 的封裝6。桌機記憶體則做成記憶體條,插在主機板插槽上。
HBM 沒辦法拿來換掉桌機記憶體條。它出廠時就和處理器封在一起,沒有插槽可拔插;以標準 HBM 來說,處理器要內建對應的控制器與負責收發訊號的實體層,照規範擺好接墊與線路,才接得上 HBM3。桌機處理器是照 DDR 記憶體條設計的。
誰在做哪一段
- 記憶體原廠:量產 HBM 的是 SK 海力士、三星、美光三家6,到 2026 年 10 月三家都已出貨 HBM410。中國的長鑫存儲 CXMT 也在開發,依產業估計仍在 HBM3 八層堆疊的階段3。
- 基底晶粒:依各公司文件,SK 海力士從 HBM4 起改用台積電(2330)的先進邏輯製程;三星的 HBM4 配自家晶圓代工的 4 奈米基底晶粒;美光的 HBM4 由公司內部設計製造,依 2025 年 9 月法說簡報,HBM4E 改與台積電合作9。
- 介面矽智財:創意(3443)的主要業務列有 HBM 與晶粒互連矽智財,也就是給客製晶片用的記憶體介面設計。
- 堆疊設備:把各層加熱加壓焊起來的設備叫熱壓鍵合機,依站內研報,ASMPT 做 HBM4 用的熱壓鍵合機6。
- 測試:依財經媒體報導,旺矽(6223)供應 HBM 晶粒封裝前做晶圓級測試的探針卡6。
以上是各家做的環節,不等於已證實的訂單或獲利。
延伸閱讀
- GPU 為什麼常在等記憶體:算力、記憶體頻寬、記憶體容量三個數字各決定什麼,看第一、三、六、九章。
- HBM 為什麼要疊、矽通孔怎麼做:頻寬為什麼靠加寬介面、打孔填銅與逐層焊接的步驟,看〈為什麼 AI 的記憶體要疊起來〉與打洞填銅那一節。
- 基底晶粒做什麼、客製 HBM 改了哪裡:標準 HBM 的介面為什麼固定,客製 HBM 把哪些邏輯搬進基底晶粒。
來源
- Samsung Semiconductor — HBM,三星官方 HBM 產品家族介紹,2026-10-28 核對。↩
- SK hynix — Creating New Values in DRAM Using TSV,SK 海力士新聞室技術文章,說明 TSV 垂直互連,並以 HBM2 時期經矽中介層接處理器的架構為例,2026-10-28 核對。↩
- 客製化 HBM 與基底晶粒,Trend Core 免費頁,2026-07-03 發布,〈標準 HBM 的枷鎖〉〈客製化 HBM 動了什麼〉〈採用方訊號〉三節。↩
- 先進封裝全景地圖,Trend Core 免費頁,2026-07-23 發布,〈2.5D 橫向拼接〉與〈Chiplet 與 3D 堆疊〉兩節;頁內產能與資本支出為發布時口徑。↩
- 美光 HBM4 的矽通孔說明,Trend Core 免費頁,2026-09-11 發布,〈矽堆疊通孔與玻璃通孔,處理的是不同工序〉一節引美光 HBM4 產品問答。↩
- 拆解 HBM 原理與製程,Trend Core 免費頁,2026-07-07 發布,導言、〈為什麼 AI 的記憶體要疊起來〉與各製程關卡的說明。↩
- HBM 12 層改 8 層的同條件算術,Trend Core 付費研報,2026-09-06 發布,引用段落〈十二層改八層若成真〉位在付費牆之前。↩
- GPU 怎麼運作,Trend Core 免費頁,2026-09-03 發布,第一、五、六、八、九章。↩
- 三家記憶體廠的基底晶粒文件與 NVHBM,Trend Core 付費研報,2026-10-19 發布,引用段落位在付費牆之前。↩
- 三家 HBM4 的出貨狀態,Trend Core 免費頁,2026-10-14 發布,〈三家都做得了,超微為什麼找三星?〉一節。↩
免責聲明
研究紀錄,非投資建議。
本文為不預測漲跌研究團隊整理公開資料的科技與商業通識內容,僅供教育與研究參考,不構成投資建議。文中提到的公司只說明其產業角色,不代表推薦,也不代表訂單或獲利已獲證實。資料以文中標示的日期與來源為準,後續變化請以最新公告為準。