TPU 全名 Tensor Processing Unit,中文稱張量處理器,是 Google 為加速機器學習設計的特殊應用積體電路,也就是 ASIC1。張量是多維的數字陣列,二維的張量就是矩陣;TPU 的設計重點是快速執行矩陣運算,這是許多機器學習工作裡的重要計算2。程式裡適合的運算由 Google 的 XLA 編譯器轉成 TPU 機器碼,其餘仍在主機上執行1。Google 自 2015 年起在自家資料中心使用 TPU3,外部使用者也能透過 Google Cloud 租用 TPU 虛擬機,不必自己買晶片2。
Google 為什麼自己做一顆晶片
依 Google 2017 年的論文,2013 年一份推算顯示,若使用者每天用語音搜尋 3 分鐘、跑語音辨識的神經網路,Google 的資料中心得翻倍才夠,用傳統中央處理器 CPU 應付會非常昂貴3。Google 於是啟動專案,做一顆推論用的客製晶片,訓練仍買市售 GPU3。訓練是讓模型從資料學出參數,推論是用訓練好的模型產生回答。
晶片裡有什麼:矩陣單元與脈動陣列
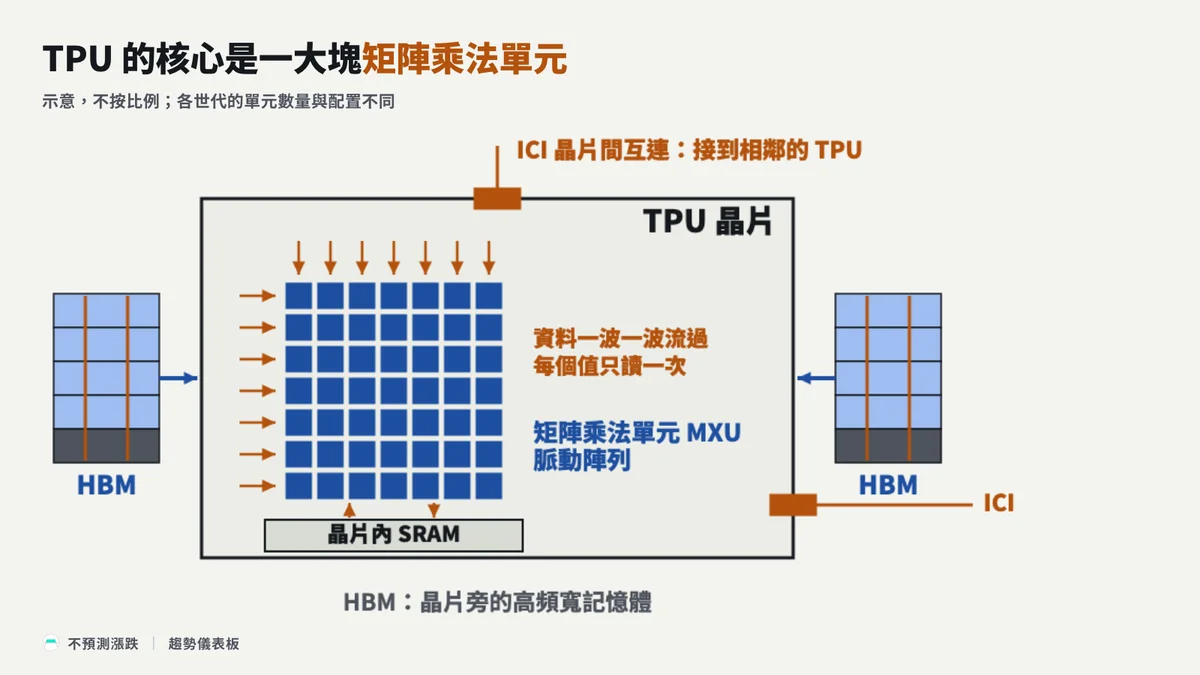
TPU 的核心是矩陣乘法單元,Google 稱為 MXU3。矩陣相乘可以拆成一連串「乘一次、加進累計值」的乘加步驟,矩陣單元把大量乘加器排成方陣,同時做很多個乘加。第一代 TPU 的矩陣單元有 256×256 個乘加器,合計 65,536 個 8 位元運算單元3;數字位數越少,同樣面積能放越多運算單元,代價是精度較低。
Google 的論文寫,讀取大塊 SRAM 比做算術還耗電,所以矩陣單元採用脈動執行,減少讀寫晶片內的緩衝區3。依 Google Cloud 的解說,CPU 與 GPU 往往每做一次運算都要存取好幾個暫存器;脈動陣列讓矩陣乘法的每個輸入值只讀一次,就在相鄰運算單元之間傳遞,重複用在許多運算上,連線只接隔壁,又短又省電3。資料像心臟泵血一樣一波一波流過晶片,「脈動」由此得名3。
可以把脈動陣列想成一條裝配線:零件從一端送進來,每個工位做完一道工序就交給下一站,不必每一步都走回倉庫取料。回到晶片上,倉庫是 SRAM,工位是乘加器,零件是矩陣裡的數字;省下的是來回搬運的電,算術本身沒有變少。
記憶體:晶片內的 SRAM 與晶片旁的 HBM
晶片內的 SRAM 速度快、容量小;近幾代 TPU 把放不下的模型權重與資料存在晶片旁的 HBM,也就是把多層 DRAM 晶粒疊起來、緊貼運算晶片放的高頻寬記憶體。HBM 容量大得多,但每次讀寫要走得比較遠、比較耗電,所以設計上會讓資料留在 SRAM 裡多用幾次。依 Google 第八代公告,推論版 TPU 8i 有 384MB 晶片內 SRAM,單顆另配 288GB HBM3。
一顆不夠:晶片互連與 pod
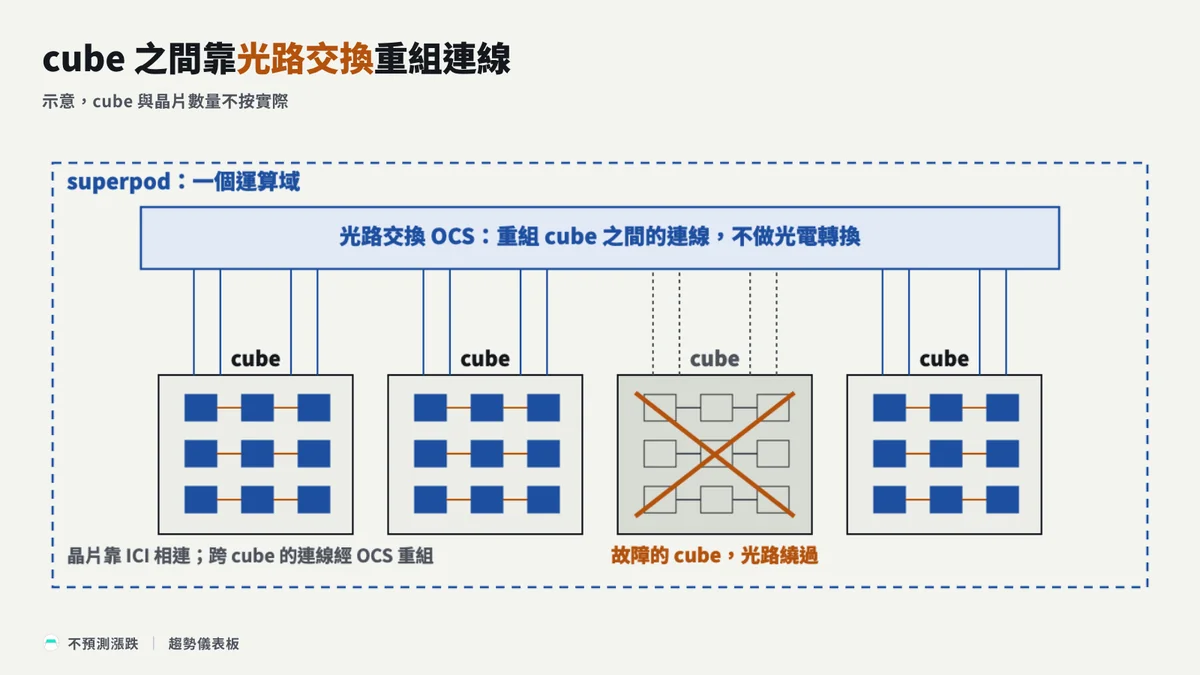
大模型一顆 TPU 跑不下,要用高速互連把很多顆接成一個整體,這一群能直接互傳資料的晶片稱為 pod,也叫運算域;pod 越大,能一起跑的模型越大。TPU 之間的晶片間互連,Google 稱為 ICI4。
依 Google Cloud 官方說明,第七代 Ironwood 的一個 superpod 就是一個運算域,由 9,216 顆晶片、144 個運算 cube 組成,晶片之間靠 ICI 相連,cube 之間的連線交給光路交換 OCS 重組4。第八代訓練版 TPU 8t 的 superpod 最多 9,600 顆晶片,共享 2PB 的 HBM3。
傳統交換機先把光訊號轉成電、決定往哪送,再轉回光;OCS 不轉換,直接把輸入光纖接到輸出光纖,兩端收發器升速時,中間的交換機不必換4。某個 cube 或連線故障時,系統會在光學層繞過它,重接只連健康 cube 的光路4。
TPU 和 CPU、GPU 怎麼分工
CPU 把晶片面積花在讓單一指令流跑快,例如大快取與分支預測5。在 TPU 系統裡,CPU 在主機端執行 TPU 以外的程式1;第八代的主機是 Google 自家的 Axion,一顆 ARM 架構 CPU3。
矩陣乘法裡每個值會被重複使用很多次,正是加速器擅長的運算5。資料中心 GPU 也有專做矩陣乘加的單元,兩者差在整顆晶片的取捨:GPU 保留更多通用的程式彈性,TPU 把更多面積與資料流押在矩陣運算上。
TPU 快不快,要看工作合不合它。Google 把矩陣運算占大宗、模型大、批次大的工作列為適合 TPU 的情境,需要高精度或頻繁分支的工作則不適合1。
所有 AI 晶片都叫 TPU 嗎
不是。ASIC 泛指為特定用途設計的晶片,TPU 是 Google 這一系列 ASIC 的名字1,其他雲端與 AI 公司也各有自己命名的加速器。
TPU 也分好幾代:第一代只做推論,之後逐步兼做訓練,到第八代拆成兩顆3。名稱對照如下3:
| 名稱 | 是什麼 |
|---|---|
| TPU 8t、TPU 8i | Google 官方的第八代產品名,前者是訓練版,後者是推論版 |
| Ironwood | 第七代的官方代號 |
| V7、V8 | 供應鏈與社群的簡寫,不是 Google 的產品名 |
| Sunfish、Zebrafish | 供應鏈媒體用語,二手來源對它們各指哪一顆說法不一 |
為什麼現在大家在談 TPU
TPU 開始走出 Google 自己的機房。Alphabet 財務長在 2026 年 7 月 22 日的第二季法說說,Google 第二季第一次認列出貨到客戶資料中心的 TPU 系統銷售;依 Alphabet 指引,既有協議的絕大多數營收落在 2027 年6。依 Anthropic 公告,它與 Google、博通簽約,取得多 GW 的下一代 TPU 算力,預期 2027 年起上線7。
誰在做哪一段
- 設計:Google 主導,第八代兩顆與 Google DeepMind 共同設計3。
- 開發與供應:博通 2026 年 4 月的 8-K 寫,它與 Google 簽了長期協議,為 Google 未來世代的 TPU 開發並供應客製 TPU,另一份協議供應 AI 機櫃用的網通與其他元件8。博通執行長在 6 月的法說說,預期 Google 會有多元的供應來源8。
- 多條設計線:依 SemiAnalysis 的 Dylan Patel,Google 同時跑三個架構不同的 TPU 設計案,一條與博通、一條與聯發科(2454),第三條未揭露9。
- TPU 旁邊的晶片:依 Marvell 的 8-K,它與 Google 的協議範圍是掛在 TPU 生態系旁的客製晶片10。
- 製造:設計完成的晶片交給晶圓代工廠製造。
以上是各家做的環節,不等於已證實的訂單或獲利。
延伸閱讀
- GPU 怎麼運作,矩陣運算為什麼適合加速器:CPU 與 GPU 把晶片面積花在哪裡,記憶體階梯與資料重用次數怎麼決定一顆加速器跑不跑得滿。
- 光路交換怎麼把一群 TPU 接成一座 superpod:OCS 為什麼不做光電轉換、升速率不必換交換機,以及它和共封裝光學分屬哪一層;前兩節講機制。
來源
- Google Cloud — Introduction to Cloud TPU,Google Cloud 官方文件,定義、XLA 編譯與適用情境段落。↩
- Google Cloud — TPU architecture,Google Cloud 官方文件,定義、矩陣運算與 TPU VM 段落。↩
- TPU 的起源、脈動陣列與第八代規格,Trend Core 付費研報,2026-08-20 發布,引用〈從一個推算開始〉〈脈動陣列〉〈從第一代到第八代〉〈3.1 官方口徑與供應鏈代號要分開看〉各節,位在付費牆之前;含 Google 2017 年論文與 Google Cloud 解說原文。↩
- 光路交換與 TPU superpod,Trend Core 免費研究頁,2026-06-20 發布,〈Google 藏了十年的東西〉與〈OCS 換掉的是交換拓撲〉兩節,引述 Google Cloud〈Inside the Ironwood TPU codesigned AI stack〉。↩
- GPU 怎麼運作,Trend Core 免費研究頁,2026-09-03 發布,〈二、先把底層搞懂〉與〈五、一條除法〉。↩
- TPU 系統銷售第一次進損益表,Trend Core 免費研究頁,2026-07-24 發布,〈從預測到記帳〉與〈先花錢、後認列〉兩節,整理 Alphabet 2026 年第二季法說。↩
- 博通與 Anthropic 之間的公開文件,Trend Core 追錢系列免費頁,2026-10-20 發布,〈哪些文件把博通跟 Anthropic 連在一起?〉表中「Anthropic 公告」一列。↩
- 博通 8-K 原文與執行長法說的對照,Trend Core 付費研報,2026-08-16 發布,引用〈這句話,六月三號就講過了〉與〈把傳聞鏈拆開〉第一條,含 8-K 與法說原文,位在付費牆之前。↩
- Google 的多條 TPU 設計線,Trend Core 付費研報,2026-09-03 發布,引用〈1.1〉第一段,位在付費牆之前。↩
- Marvell 與 Google 協議的範圍,Trend Core 付費研報,2026-08-24 發布,引用〈1.1 動詞是「attach to」,不是設計〉,含 8-K 原文,位在付費牆之前。↩
免責聲明
研究紀錄,非投資建議。
本文為不預測漲跌研究團隊整理公開資料的科技與商業通識內容,僅供教育與研究參考,不構成投資建議。文中提到的公司只說明其產業角色,不代表推薦,也不代表訂單或獲利已獲證實。資料以文中標示的日期與來源為準,後續變化請以最新公告為準。